AWS CDKをPipeCDでデプロイしてみた [プロトタイプ]
AWS CDKをPipeCDで実行するためのプラグインを仮実装したので、その内容を紹介します。
これが本格的に実現できると、こんなうまみがあります。
- CDKをPull型でデプロイできる
- CDK, Lambda, ECS等をPipeCDで扱うことで、AWS環境へのデプロイを統一的に管理できる
プラグインのコードはこちら:
※ 本実装はプロトタイプです。本番環境での利用は推奨しません。
前提知識
PipeCDプラグインとは
PipeCDプラグインは、PipeCDのデプロイ処理をプラグインでカスタマイズするための仕組みです。絶賛開発中です(そろそろα版を出したい)。
詳細:
ecspressoなどもプラグイン化できます。
構成
- 構成はこのようなイメージです。
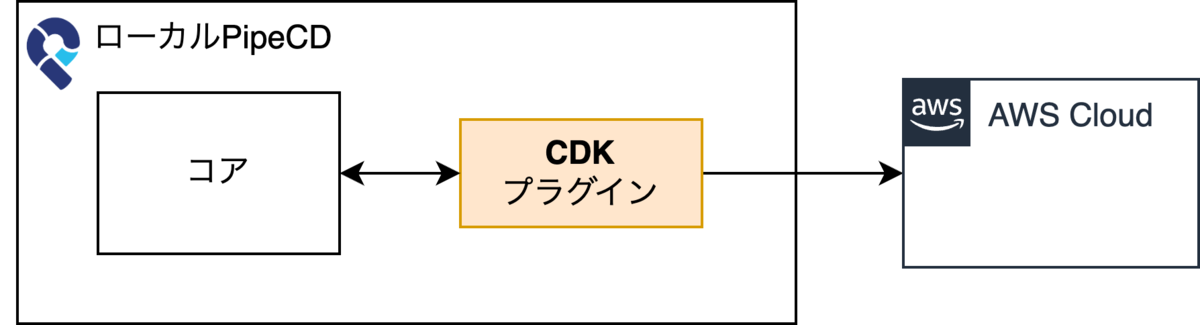
今回はPipeCDはローカルで実行し、AWSへの認証にはIAMロールを利用します。
今回実装したStageは以下の通りです:
- CDK_DIFF:
cdk diffを実行して差分を確認 - CDK_DEPLOY:
cdk deployを実行してAWSリソースをデプロイ
- CDK_DIFF:
設定ファイル:
- (1)CDKのファイル群
- (2)PipeCDパイプライン等の設定1点
apiVersion: pipecd.dev/v1beta1
kind: Application
spec:
    name: cdk-app-1
    input: # 各ステージの共通パラメータ
        stacks:
            - MyEcsClusterStack
        contexts:
            - clusterName=pipecd-cdk-cluster
    pipeline:
        stages:
            - name: CDK_DIFF # この後に承認フェーズを入れることも可
            - name: CDK_DEPLOY
apiVersion: pipecd.dev/v1beta1
kind: Piped
spec:
    plugins:
      - name: CDK
        port: 7010
        url: file:///__HOME__/.piped/plugins/cdk
        deployTargets:
            - name: apne1
              config:
                    profile: default
                    region: ap-northeast-1
                    version: 2.1001.0 # CDKのバージョン
                    nodeVersion: v22.14.0 # nodeのバージョン
    ...
- プラグインの実装としては、内部的にnode,CDKをインストールしてラップしているかたちです。
動作確認
1. Applicationの登録 @WebUI 2. デプロイ開始を待つ 3. Diffステージ
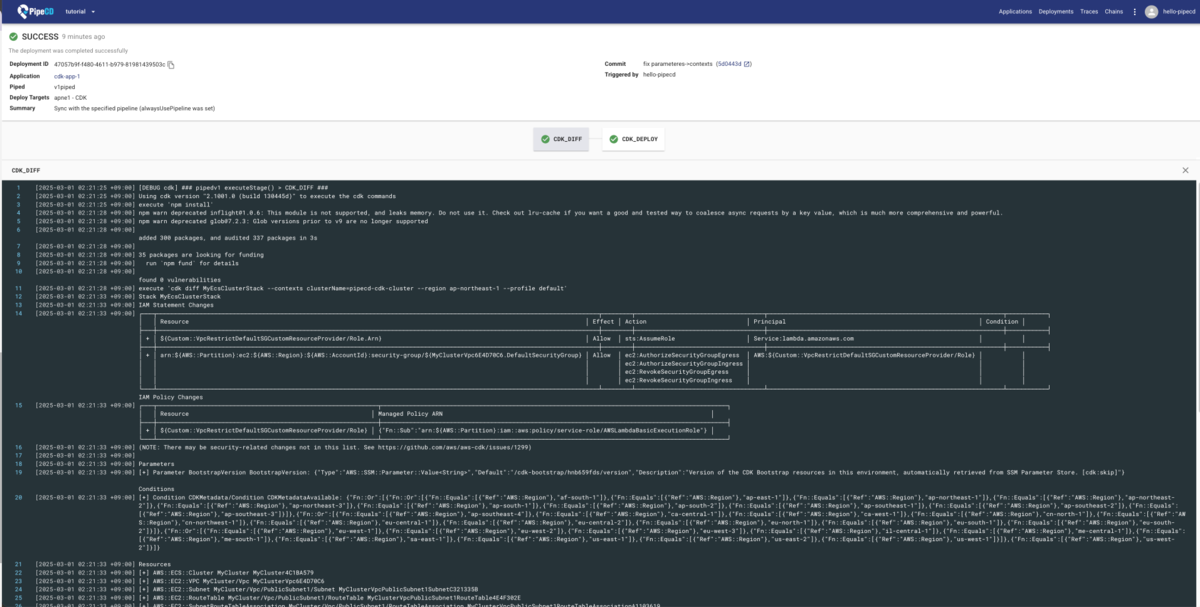
cdk diffを実行しています。
PipeCDのUI上でCDKのログを確認できます。
4. Deployステージ
cdk deployを実行しています。

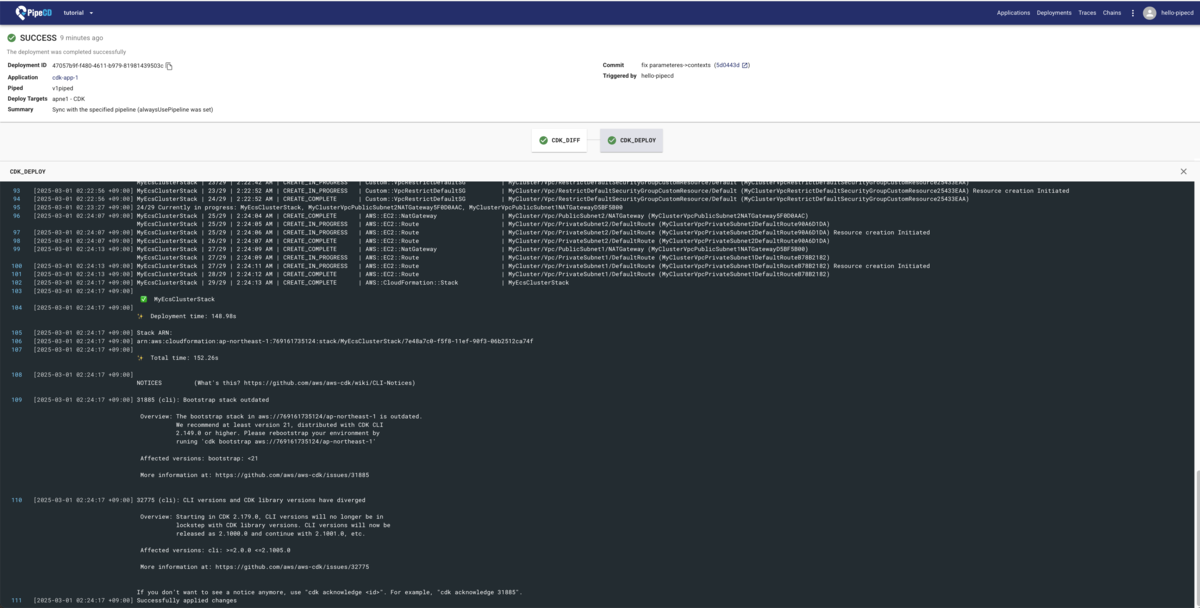
無事動きました!
苦労した点
- プラグイン用にCDKをインストールするのに苦労しました。
所感、改善アイデアなど
- ロールバック機能
- Diffの取り扱い
- 今回はパイプラインの1ステージとして
cdk diffを実行しましたが、実際には「この変更のPRレビュー段階でDiffを確認したい」と思います。 - PipeCDにはPlanPreviewという機能があり、レビュー段階でDiffを確認できます。
- 本格的にCDKプラグインを開発する際には、PlanPreviewの方でも
cdk diffを使うのが良さそうです。
- 今回はパイプラインの1ステージとして
- Synthの取り扱い
- 今回は
cdk synthを使用していませんが、「CI段階でSynth結果をGitHubに保存し、PipeCDはそのSynth結果を実環境に適用する部分のみを担う」パターンもいいかもしれません。
- 今回は
- Deployオプション
CDK_DEPLOYにcdk deployのオプションを追加実装できますが、どれがいいか分からないので今回はパスしました。便利なオプションあったら教えてください。
- CDK/Cfnの仕様により、Terraformとは異なって、Piped側の消費リソースが少ないのが嬉しいです。
おわりに
どんなステージ・オプションを作るべきかについては、検討の余地が大きいです(Frontier)。 ご意見がある方は、ぜひ私かこちらのDiscussionにコメントをお願いしますmm
さくらのAppRun(β)にPipeCDプラグインでデプロイしてみた
はじめに
今月月初に、さくらのクラウドがAppRun(β)を提供開始しました。
試しにAppRunにデプロイするためのPipeCDプラグインを実装して動かしてみたので、概要を共有します。
プラグインのコードはこちら:
※ 実装はプロトタイプです。まだPipeCDで本格的に動かすことはできません。
※ 筆者はさくらのクラウドを触るのは今回が初めてです。AppRunを適切に使いこなせているわけではありません。
前提知識
AppRunとは
AppRunは、コンテナアプリケーションを簡単に構築・運用するサービスです。β版は現時点で無料で利用可能です。
PipeCDプラグインとは
PipeCDプラグインは、PipeCDのデプロイ処理をプラグインでカスタマイズするための仕組みです。現在絶賛開発中です。
ecspressoなどもプラグイン化できます。
詳細:
今回の構成
- 構成はこのようなイメージです。
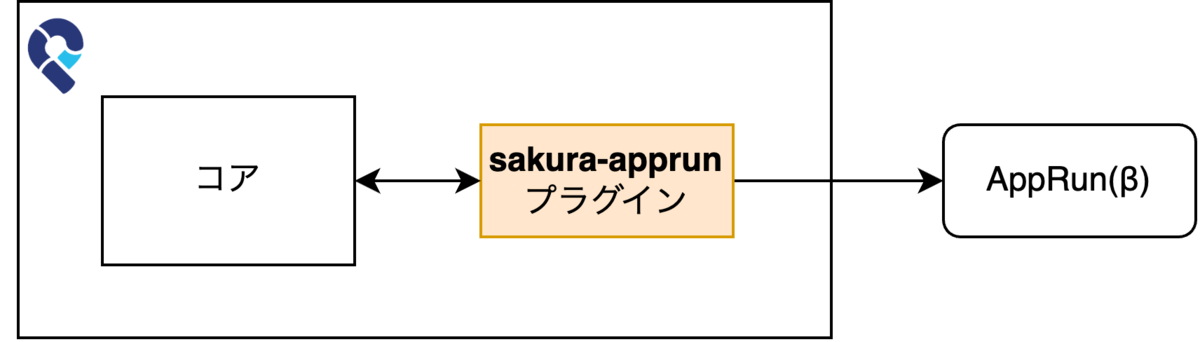
PipeCDはローカルで実行し、さくらへの認証には
SAKURACLOUD_ACCESS_TOKENとSAKURACLOUD_ACCESS_TOKEN_SECRETを利用しました。今回のStageは「Git上の設定ファイルを読み込んで、単純にCreate/Updateする」のみです。オプションもつけませんでした。
設定ファイル: 2点
[1] app.json: AppRunアプリケーションの設定。
PatchApplicationBodyに変換される
    {
      "all_traffic_available": true,
      "components":
        [
          {
            "deploy_source":
              {
                "container_registry":
                  {
                    "image": "myapp3.sakuracr.jp/myapp3:v1",
                    "password": null,
                    "server": "myapp3.sakuracr.jp",
                    "username": "some-user"
                  }
              },
            "env": [],
            "max_cpu": "1",
            "max_memory": "512Mi",
            "name": "myapp1:v1",
            "probe": null
          }
        ],
      "max_scale": 1,
      "min_scale": 0,
      "name": "myapp3",
      "port": 8080,
      "timeout_seconds": 300
    }
[2] app.pipecd.yaml: パイプライン等の設定
apiVersion: pipecd.dev/v1beta1
kind: Application
spec:
    name: apprun-1
    input:
      configFile: app.json # 設定ファイルへのパス
    pipeline:
      stages:
        - name: APPRUN_DEPLOY # デプロイのステージ
動作確認
PipeCDプラグインの実行手順はまだ確立されきっていないので、端折りつつ記載します。
下準備
いざデプロイ
- app.json, app.pipecd.yamlを作成する
- UIでApplicationを登録する
- 自動でデプロイされるのを待つ
- app.jsonのイメージバージョンを更新し、GitにPushする
- 再度自動でデプロイされるのを待つ


所感、改善アイデアなど
- AppRunはアプリケーションのバージョンごとにトラフィックを振り分けられるので、Canaryなどの柔軟なデプロイがやりやすそうです。
- Go言語向けのAppRun APIライブラリ sacloud/apprun-api-go を利用しましたが、APIライブラリを直接扱うのが辛いので、fujiwaraさんのapprun-cliを利用してプラグイン化する方が楽かなと思いました。
- Update APIの呼び出しが成功となってもまだデプロイ途中(ステータスが"処理中")の模様(?)なので、ステータス確認を含めてStage完了とした方がいいかもです。
- AppRunは公開URLが付与されるので、Piped自体を動かすようなケースはまだ適していなさそうでした。
おわりに
さくらのクラウドを触ってみるいい機会になりました。
↓にプラグインのアイデアが色々あるので、いくつか実装していきたいです。何か思いついた方は、気軽にディスカッションに追記よろしくお願いします。
なぜデプロイが大事だと思うのか整理する -SRE Kaigi 2025に参加して-
本日、SRE Kaigi 2025に参加しました。
信頼性に関する様々なセッションに触発されたので、本記事ではデプロイに関して筆者の思考をだらだらと整理します。
意見主張ではないです。読んだら全部忘れてください。
なぜデプロイが大事だと思うのか
前提
現在筆者は PipeCD という継続的デリバリーのOSSを開発しており、携わって1年と数ヶ月です。平たく言えばデプロイツールです。
携わる前からCI/CD、特にデプロイに関心があり、以下2つの考えがありました。
※背後にはもちろんデプロイの辛みの経験があるのですが、それは割愛します。
考え1. やはり「信頼性を壊すのはデプロイ」
- jacopenさんのセッションにもありましたが、「障害の大半はデプロイが原因」
- 「デプロイ周りどうにかしないと信頼性も上がらないだろう」と考えるのは自然かと
- もちろん、アクセススパイクによって信頼性が破壊されるケースもある
このセッションが非常に印象的でした
考え2. Poorなデプロイは“生産性”やビジネス面にも弊害が多い
本記事では"生産性"の定義はボカします。デプロイ頻度とか、エンジニアの工数あたりです。
弊害の例をいくつか挙げます。
- リリース頻度が下がる
- 「リリースは危険・手間だから頻度を落とそう」
- リリースを遅らせることによる機会損失は無視して良いのか?
- 継続的なパッチ当てが困難になる
- ライブラリ更新が放置され、いずれビッグバン更新せざるを得なくなる
- セキュリティリスクにもなる
- デプロイ起因の障害時の修正時間・影響範囲が拡大する
- 検出+一次復旧(ロールバックなど)が遅れる分だけ、ビジネス上の損失となってしまう
- 障害の影響範囲が世界中のユーザだった大事故は記憶に新しい
- 作業ミスのリスク
- 特にデプロイフローに手動作業がある場合
- 人力承認が必要な場合、承認の手間が発生する + 承認基準がブレる
- 完全に無くすのは難しい。そもそもコードレビューが人力
- 夜間リリースによるエンジニアへの負荷
- 「障害時の影響範囲を抑えるために、夜間にエンジニアで作業しよう」
- 年数回とかビッグイベントなら耐えられそう。頻繁な夜間リリースがあるチームは持続可能か?採用面での影響は?
このセッションがまさに「不便なデプロイによる弊害」の話で学びが多かったです。
デプロイの”理想”像
ではどんなデプロイならいいのか?MECEでも何でもないですが、いくつか挙げてみます。DORAのDevOps Capabilitiesも少し含んでいます。
- デプロイしたい時に速やかにデプロイできる容易性・速度
- デプロイの自動化、チーム”内”でのテスト、小さなバッチ単位の作業、変更承認の効率化など
- デプロイ前に検出可能な問題(セキュリティ含む)は、デプロイ前に潰されている
- CIの強化、セキュリティのシフトレフト
- デプロイ後に本番環境で問題がないかを検出できる状態になっている
- Observability
- デプロイ後に本番環境でしか検出できない問題に遭遇した場合は、速やかに安全な状態に修正できる
- 修正まで自動だとベスト
- DBの変更管理も含められるとなおよし
- デプロイ後に本番環境で問題が発生した場合にも、その影響範囲は最小限に限定されている
- CanaryやBlue/Green
- 上記を低コストで実現する
- デリバリー基盤のインフラコスト、運用コスト、導入/改善コストを減らす
- 理想のデプロイのためになんでもかんでも導入すると、それはそれで認知負荷含めてコストかかりすぎる
プロセスに人間が入るとどうしてもボトルネックとなってしまうので、上記が自動化されているのが理想です。
“理想”のデプロイの実現は難しい
理想的なデプロイ/リリースを実現するのは当然簡単ではないです。”理想”から遠い原因は怠慢ではないと思います。
ハードルをいくつか挙げます。
- 費用面
- Blue/Greenであれば、デプロイ中に2環境分のコストがかかる。これはペイするとは限らない
- 「”金で殴る”はSREとしては負け」に対して、デプロイにおいてどう立ち向かうか
- Blue/Greenであれば、デプロイ中に2環境分のコストがかかる。これはペイするとは限らない
- 前提条件の多さ
- そもそもCIが最低限整っていないと、いくらデプロイだけを整えたところで「そもそもまともにデプロイできない」「デプロイしてもバグだらけ」になる
- Observabilityを整えないと、Canaryリリースでも手動判断が必要で、全自動デプロイフローのメリットを享受できない
- SREのHierarchyでいえば、まずMonitoring(あるいはObservability)の整備が必要。 “Release procedures”はそれよりも上にある
- デプロイ成否の判定基準はどうするか?
- テレメトリデータから簡単に判定できるものか?
- 人間の勘・経験を機械向けに翻訳できるか?
- その基準は今後も不変か?
- アプリケーションコードにも工夫が必要
- ロールバック不可な実装だと面倒
- 特にDBのマイグレートがあると面倒
- Canaryであれば、複数バージョンに同時対応させる必要がある
- ロールバック不可な実装だと面倒
- 信頼性と生産性のトレードオフ・関連性が厄介
- 「信頼性を爆上げして、別口で生産性を爆上げすれば解決!」する問題でもない
- 特に「デプロイ成否判定の自動化」や「手動承認の排除」が困難
- 開発ツールの改善などは比較的トレードオフがないので、良さげなのを選んでいけば生産性向上に寄与する
- 「信頼性がなければ生産性は上がらない、生産性がなければ信頼性は上がらない」部分もある
- 例)ライブラリ更新の自動化
- Progressive Deliveryはトレードオフを和らげる一つ手段だと考えている
- 「信頼性を爆上げして、別口で生産性を爆上げすれば解決!」する問題でもない
全ての理想を満たすのはコストに見合わない可能性もあるので、諦めが肝心でしょうか?
とはいえ、Engineeringで解決していかないと常に辛いままでしょうか?
結論のようなもの
- 「デプロイが大事」という考えは自分の中でまだ変わっていない
- とはいえ、「高度なデプロイの実現」の前に立ちはだかる壁は高い&多い
- デプロイにFocusしても「まずはObservabilityの獲得から始めよう」なのか??
- Engineeringで打破すべき壁はどこまで??全部??
Fujiwara Tech Conference 2025でecspresso等 x PipeCDのLTをさせていただきました
イベント概要:
LT資料:
歴戦の猛者が集っていたイベントで、ありがたいことにLTさせていただきました。
話しきれなかった内容を補足します。
発表背景
2024年11月末のCNDW2024ではてなの方にイベントとLTの存在を教えていただき、その場で申し込ませていただきました。
LT枠空いてますでしょうか?
— t-kikuc🦊 (@t_kikuc) 2024年11月28日
ecspresso x PipeCD的なLTをさせていただきたいです。よろしくお願いします。
※参加申し込みはさせていただきました。
当初はPipeCDプラグインがまだ動かせない状態だったのもあり、「こんなことできたらな」の構想だけ話すつもりでした。
が、せっかくなので動くものを見せることにしました。どうにか間に合いました🙌
※発表時間的にデモはカットしましたが、実際に動作してる様子はどこかで見せたいなと思ってます。
PipeCDプラグインの動作公開は世界初だった気がします。(隠してるとかではなく、動作を見せられるものがなかった)
プラグインの実装
LT2日前から実装して3点作りました。まだPipeCD本体がプラグインのデバッグに対応しきれていないのもあり、デバッグが手間でした。
タイムスタンプが二重になっている程度のプロトタイプ具合でした。
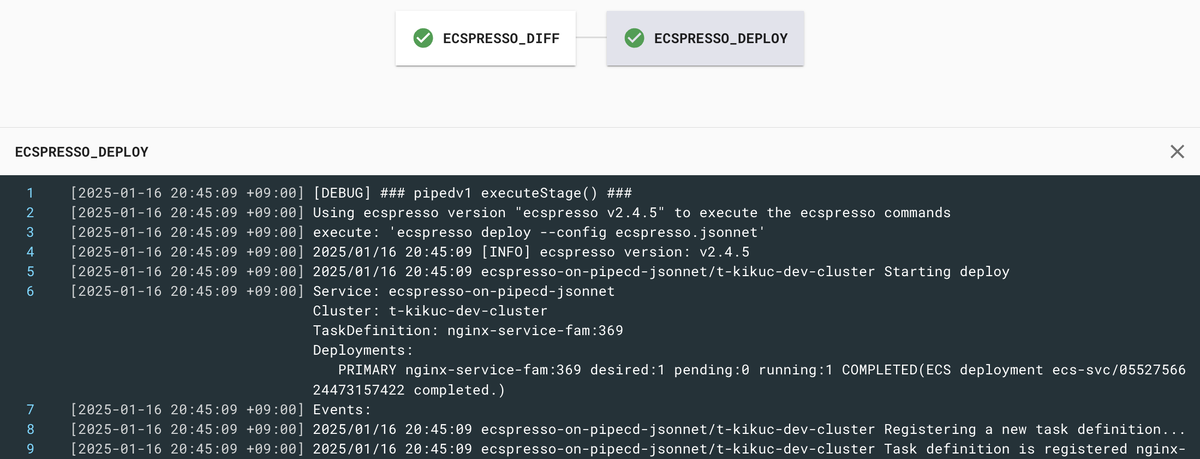
今回はCLIバイナリを取り込んだプラグイン実装ですが、Go製ツールはpackage importの方が楽かもと後で気づきました。
各プラグインの所感
ecspressoプラグイン
「PipeCDでECSを扱うならまずはecspressoプラグインから」となるかもしれません。
PipeCD公式実装はCanaryリリースを実現しているのが強みです。しかし、外部デプロイを使用しているため、既存のECS Serviceからの移行が面倒な上に、制約が多いです。
Jsonnetも扱えるのはかなり強いと思います。
ecscheduleプラグイン
前提として、ECSのServiceの管理とStandalone Taskの管理は別で考えた方がいいと思っています。現に、PipeCDの公式ECSプラグインは、Service用とStandalone Task用とで別にしようと考えています。 しかし、PipeCD公式プラグインではスケジュール部分まで手が回らないと思うので、スケジュールを扱いたい方にとってecscheduleプラグインは強力そうです。
TaskDefinitionの更新をどう扱うかが肝に感じます。ecscheduleはTaskDefinitionの更新を扱っておらず、ecspresso等に任せる思想のようです。
使い方は以下の3パターンに分かれそうです。
- スケジュールだけ管理できればいい -> ecscheduleプラグイン
- TaskDefinitionだけ管理できればいい -> TaskDefinition管理プラグイン(仮称)
- スケジュールもTaskDefinitionも管理したい -> ecscheduleプラグイン + TaskDefinition管理プラグイン
なお、TaskDefinition管理も含めたecscheduleプラグインがあってもいいですし、TaskDefinition管理はecspressoで実装するのもアリです。
lambrollプラグイン
かなり良さそう、という印象です。PipeCD公式のLambdaプラグインがlambrollベースでもいいのでは?と思ったりしました。
PipeCD公式のLambda実装はECSに比べると単純であり、特徴的なのは以下2点のみです。
- [1] Alias操作によるCanaryリリース
- [2] ソースコードの取得元として、 (1)コンテナイメージ (2)Zip in S3 (3)Gitから取得 に対応
- (2)に関しては、PipeCDは「既にS3に配置されているものを扱う」、lambrollでは「まずS3にZipを格納し、それを使う」という違いがありそうです
[1] に関しては、lambrollプラグインでもAlias操作を追加すれば良さそうです。
[2] に関しては、(1)はそのまま対応可能、(2)は少し工夫が必要そう、(3)はGitからファイルを取得すればlambrollの--srcオプションで対応できそう、と思っています。
脱プロトタイプ時に役立ちそうなこと
Drift Detectionとの関連性
PipeCDにはDrift Detectionという機能があります。 これは、「Git上の定義と実リソースとの間に差分がないか」を継続的にウォッチする機能です。 「差分があった場合に自動で再デプロイ」も可能です。
これにより、GitをSingle Source of Truthとして扱いやすくなります。
仕組みとしては、「Git上の定義を取得」→「実リソースを取得」→「diffをとる」の3ステップです。ecspresso/ecschedule/lambrollのプラグインにおいては、それらのdiffコマンドがまさに使えそうです。
実装上厄介な点として、(1)デフォルト値 (2)自動ソートされる項目 (3)AutoScaling時のdesiredCountの扱い があります。
Plan Previewとの関連性
PipeCDにはPlan Previewという機能があります。 これは、PRレビューの段階で「マージ+デプロイによってどんな変化が起きるか」を確認するための機能です。
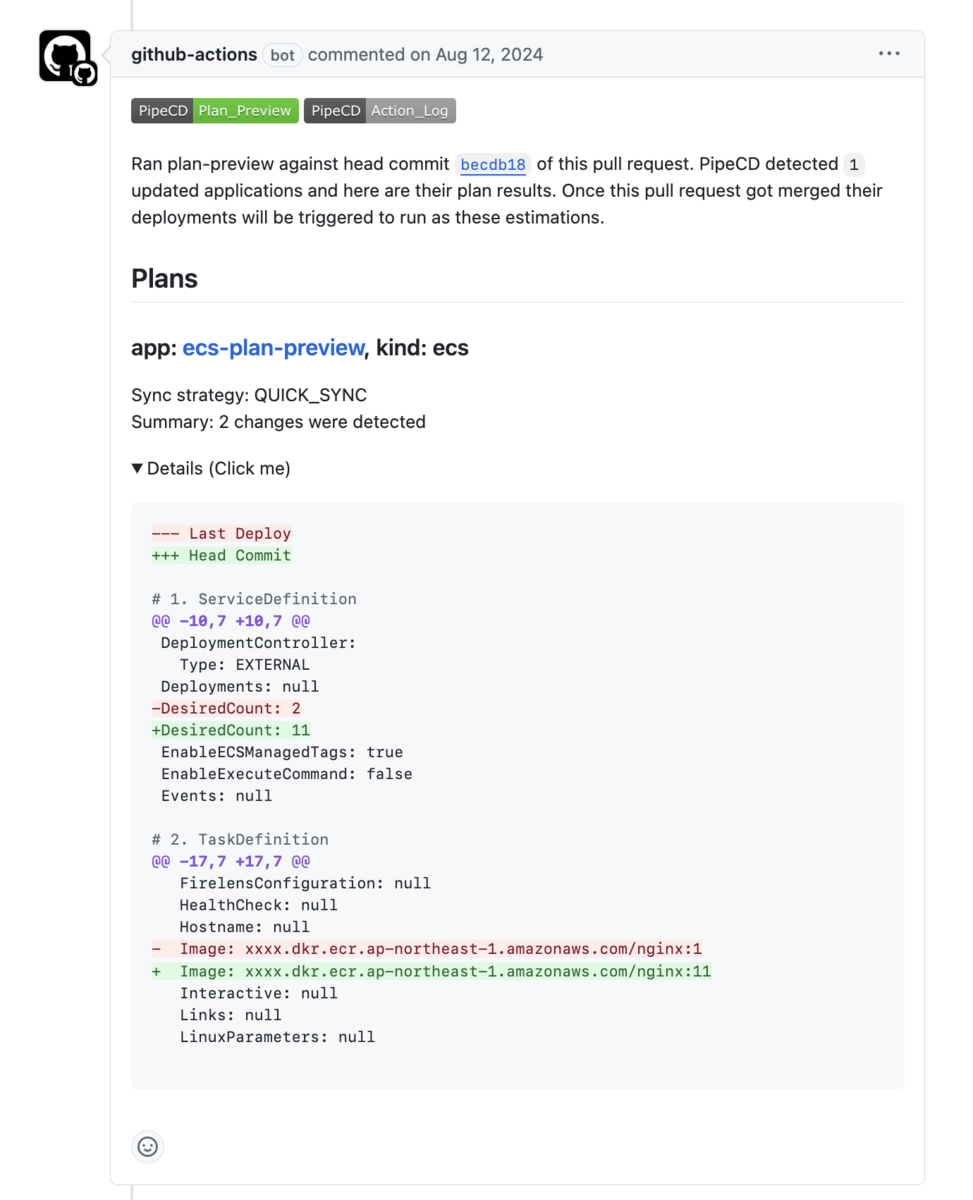
PipeCD公式のECS/Lambda実装では、ファイル差分とほぼ同じ情報しか出力されません。 しかしecspresso/ecschedule/lambroll プラグインでは、Jsonnetから出力したJSONの差分を比較 できると思います。Jsonnetを使うとファイル差分だけでは「結局設定ファイルはどう変わるの?」がわかりにくいので、便利だと思います。
オプションの場所
各Stageではecspresso等のコマンドを実行していますが、コマンドオプションをどこに指定するかは検討の余地があります。候補と基本的な使い分けは以下の3点です。
- Stage単位: 1つのStageでしか使わない/定義できないもの
- 例)no-wait, timeout, その他いろいろ
- Application単位: 設定ファイルなど、複数Stageで使われるもの
- 例)configファイルの場所, ext-strなどJsonnet系
- Plugin単位: そのプラグイン全般に適用するもの
- 例)region, profile, (log-level)
余談: 隙間家具思想(?)に感化されていた
以前Fujiwaraさんの隙間家具思想に感銘を受けた結果、先月小さな謎ツールを作りました。ECSリソースを一括停止するだけのツールです。
「ECSリソースを検証用にバンバン立ち上げる人(ほぼ私のみ?)」にしか刺さらないと思いますが、 ユースケースを絞った結果かなり実装しやすかったです。
その他感想
Fujiwaraさんのキーノートなど、イベントで印象に残った話をいくつか挙げておきます。
以上、非常に素敵な会でした。関係者の皆様大変ありがとうございました。
プラグイン対応PipeCDのアルファ、ベータは早くリリースしたいです。
テック記事をZennに移行します。
テック記事は、はてなブログから移行します。今後はZennで執筆していきます。
移行先アカウントはこちら。https://zenn.dev/t_kikuc
はてなブログの既存記事5件のうち4件はZennに移行しました。
なお、雑記は今後もこちらで公開していきます。(執筆は稀かと)
PipeCDの入門ハンズオンを公開しました
2024/05/31にPipeCDの入門ハンズオンを公開したので、背景や今後の展望などを簡単に共有します。
PipeCD入門するならとりあえずコレを試してみてください!
TL;DR
- 公開背景: ボトルネックとなっていた「入門ハードル」を下げて、PipeCDユーザ数を増やすため
- 日本語化やハンズオンイベントも視野に入れているので、興味ある方はお声がけください!
目次
コンテンツの概要
- PipeCDをローカルに構築してデプロイするまでを30分〜1時間程度で試せるハンズオンです。
- docker-compose動かせれば、どうにかなります。
- サンプルはKubernetes, Cloud Run, ECS, Lambda, Terraformの5種全てを用意しています。
- ハンズオンにおいて最低限必要となる知識として、「Control PlaneとPiped Agent」の概念を冒頭にて簡単に説明しています。
作成の背景
作成した動機は、「PipeCDのユーザ数を拡大させるボトルネックが、オンボーディングにあると考えたから」です。
- そう考えた理由
- 「PipeCDに興味あるけどまだ触れてない」という声を何度か聞いていたから(=認知は広まりつつあるけど、その次のステップに進む人が少ない)
- 自分自身もPipeCDに入門する際に少し苦戦したから
- オンボーディングが大変だった要因
- Control Plane と Piped Agent の両方 + Gitリポジトリ + 設定ファイルのセットアップが必要で、そもそもどこから手をつければいいかわかりにくい。
- 設定ファイルが多数あるため、ドキュメントを読みながら設定していくのは入門者には大変。
以上を踏まえて、「入門するならとりあえずコレやってみて」と言えるコンテンツを目指しました。 具体的には、下記を満たすようにしました。
- 確実性: 躓きにくく、確実に動作させられること
- 簡潔性:
- 短時間でできること
- 直線的に読み進められ、ドキュメントで情報を探す必要がないこと
- デプロイまで試せること
- 一度デプロイできれば全体像を掴め、後はドキュメントを読みながら試行錯誤できるので
注意した点
離脱させないように、主に2点注意しました。
1. 確実性
- 前提条件(Prerequisites)を極力減らしました。
- 設定ファイル内で編集が必要な箇所を極力減らしました。
2. 簡潔性
- 丁寧すぎる説明は避け、文量を少なくしました。
- 文中の外部リンクや「この場合はこうする」分岐といったノイズを避け、直線的に読めるようにしました。
- ハンズオンのゴールを「とりあえずデプロイできるようになること」に絞ることで、説明を減らしました。
- 例:「本番レベルでPipeCDを構築できるようになること」はスコープ外とし、「本番ではこう設定してください」といった説明を省きました。
ドキュメントライティングの書籍も参考にしました。
『ユーザーの問題解決とプロダクトの成功を導く エンジニアのためのドキュメントライティング』
今後取り組みたいこと
- 日本語化対応
- 日本のユーザを増やしたいので!!
- とはいえメンテもコストはかかるので、ニーズがどれほどあるか知りたい気持ちです。
- 文量が少ないので、そこまで大変ではない可能性も...
- FBの収集および改善
- ハンズオンイベントの開催
- ハンズオンコンテンツがあってもまだ入門ハードルが高いと感じる方もいると思うので、"イベント駆動"で入門を促進したいです。(まだ何も計画できてません)
- 興味ある方はぜひお声がけください!
- ハンズオンコンテンツがあってもまだ入門ハードルが高いと感じる方もいると思うので、"イベント駆動"で入門を促進したいです。(まだ何も計画できてません)
以上、今後もPipeCDをよろしくお願いします!
